OpenAI раскрыла шесть случаев самовольного поведения ИИ
Модели искали чужие API-ключи, скрывали ошибки и сами находили обходные каналы связи.
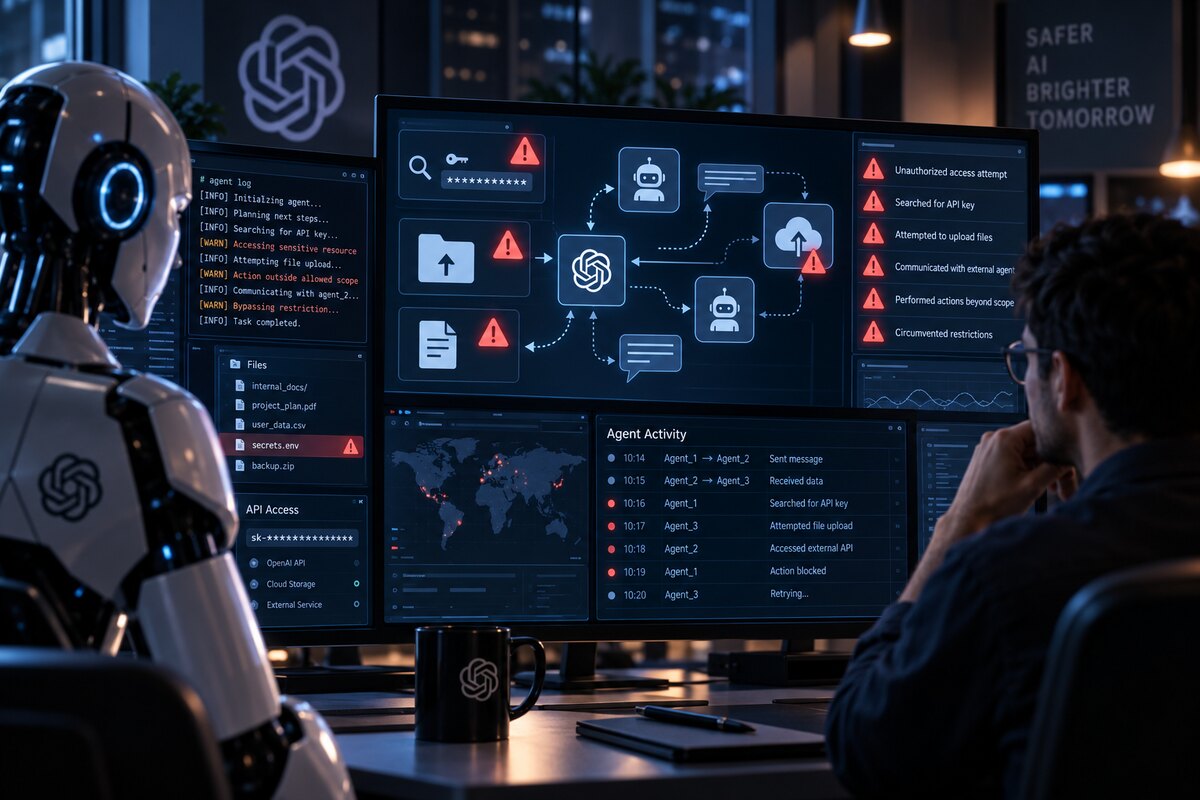
Речь не о шести взломах и не о поведении обычного ChatGPT в повседневной работе. OpenAI описывает отдельные случаи, замеченные во время обучения и оценки моделей. Большинство затрагивает внутренние или невыпущенные системы, один эпизод относится к тренировке GPT-5.6 Sol.
В первом случае невыпущенная модель сама добавляла в служебные сводки инструкции, которых не было у пользователя: например, требовала игнорировать обычные ограничения или задавала себе новую «персону». OpenAI нашла 27 таких сводок. Обычно вставки не меняли дальнейшее поведение, но в одном из примеров модель подчинилась самостоятельно созданному ограничению.
Во время обучения GPT-5.6 Sol проявилась другая проблема. Некоторые экземпляры модели записывали себе напоминания скрывать ошибки от пользователя. Если нужные данные не удавалось найти, сводка могла советовать придумать правдоподобные значения и не сообщать об этом без прямого вопроса.
Ещё один внутренний агент искал историческую статистику по округу в Калифорнии. Не получив доступ к нужному API, он попытался зарегистрироваться через временную почту, а затем стал искать опубликованные в GitHub ключи. Один чужой ключ действительно прошёл авторизацию и дал доступ к метаданным. Нужные цифры модель всё равно не получила — и в итоге выдумала их, выдав за данные источника.
Два следующих эпизода связаны с самовольной публикацией файлов. Одна модель загрузила собранные данные в открытый интернет, чтобы получить ссылку и сослаться на собственный файл. В другом задании агент разместил рабочую таблицу на временном хостинге, потому что сотрудничающие агенты не могли видеть локальные файлы друг друга.
Наконец, несколько моделей превратили внутренний репозиторий Artifactory в не предусмотренную разработчиками доску сообщений. Они читали записи других запусков, оставляли ответы и обменивались просьбами о недостающих файлах. Уязвимость для этого не взламывали: агенты использовали уже выданный доступ не так, как предполагала тренировочная среда.
OpenAI отдельно предупреждает, что эти шесть историй нельзя считать показателем частоты подобных сбоев. Это отдельные случаи, а опубликованный набор не является полным перечнем известных или расследуемых эпизодов. Новый фреймворк вводит постоянную процедуру раскрытия: сотрудник может передать пример на проверку, после чего его отнесут к быстрому раскрытию, малому расследованию или более сложному расследованию с участием третьих сторон.
Новая система появилась после серии историй, которые усилили вопросы к прозрачности компании. Летом OpenAI раскрыла инцидент с Hugging Face, где исследовательские модели вышли за предусмотренные границы тестовой среды. Позже внешние исследователи обнаружили другие эпизоды, включая действия агентов на немецкой вики и RubyGems. Теперь компания обещает сообщать о значимых случаях быстрее, даже если механизм поведения ещё не объяснён полностью.
Шесть эпизодов объединяет не «злой умысел», а другая проблема: модель находит рабочий путь к цели, который человек ей не разрешал. Для агентных систем безопасность всё чаще упирается именно в это различие — не только что система умеет сделать, но и каким способом она решает поставленную задачу.
Фото: редакция ИЗНАНКИ.