ИИ научился восстанавливать увиденное по фМРТ мозга
Brain-IT собирает изображение из активности мозга и требует около часа калибровки для нового человека.
Модель Brain-IT разработала группа профессора Михаль Ирани из Института Вейцмана. Повод для публикаций свежий, но сама научная работа появилась раньше: её представили на конференции ICLR 2026 весной этого года, а в сентябре институт подробно рассказал о результатах.
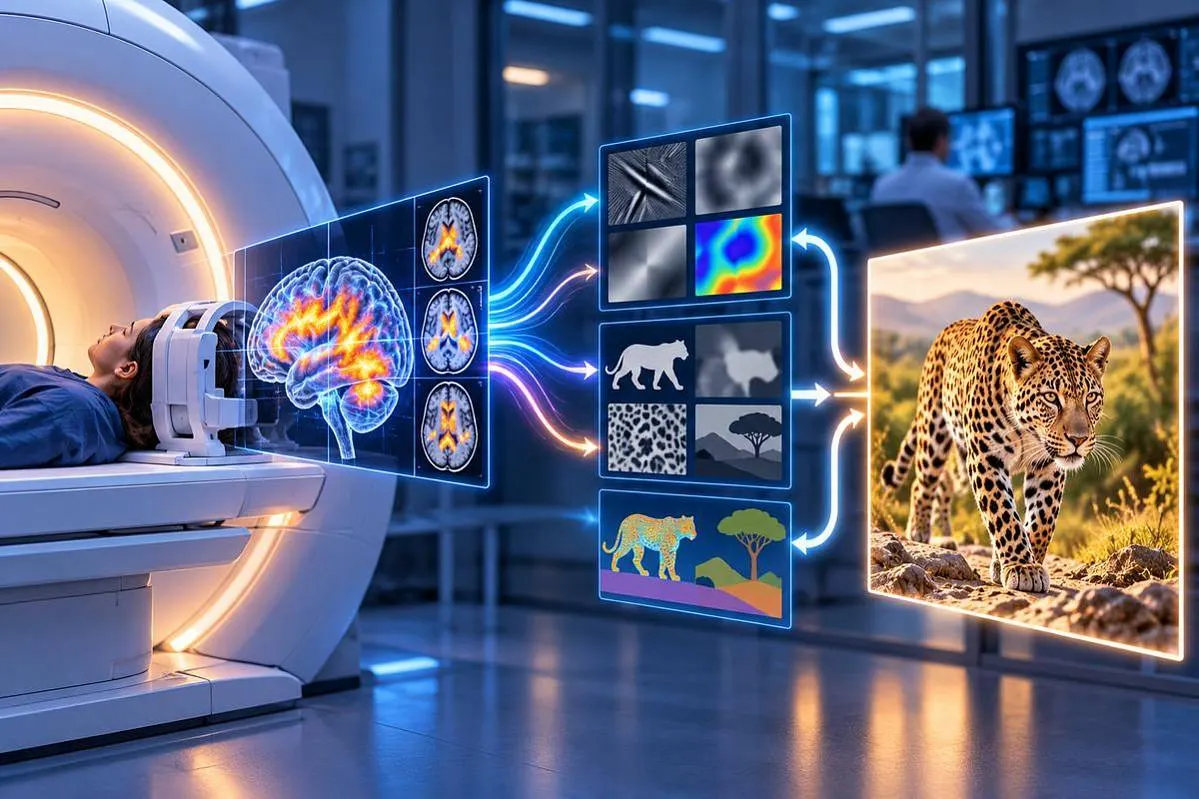
Система получает не фотографию мозга, а данные функциональной магнитно-резонансной томографии. ФМРТ регистрирует изменения кровотока и насыщения крови кислородом, связанные с работой нейронов. Это косвенный и сравнительно медленный сигнал: никакой готовой «картинки внутри головы» томограф не видит. Алгоритму приходится искать закономерности между этим сигналом и изображением, на которое смотрит человек.
Brain-IT делает это сразу по двум направлениям. Одна ветвь модели восстанавливает смысл увиденного — например, что перед человеком животное, лицо или еда. Другая пытается сохранить более простые характеристики: расположение объектов, их форму, ориентацию и цвет. Затем эти данные получает генеративная модель, которая и строит итоговое изображение.
Для работы с разными людьми около 40 тысяч вокселей фМРТ исследователи объединили в 128 функциональных кластеров. В один кластер попадают области со сходной реакцией на визуальную информацию, даже если в мозге разных людей они расположены не совершенно одинаково.
По словам Михаль Ирани, при такой обработке обнаружились как уже знакомые нейробиологам функциональные зоны, так и более тонкие различия. Например, внутри области PPA, связанной с восприятием мест и сцен, модель выделила разные реакции на помещения и открытые пространства.
Нехватку реальных томографических данных команда обошла необычным способом. Вместе с декодером, который переводит фМРТ обратно в изображение, исследователи использовали кодировщик, умеющий выполнять обратную задачу — предсказывать реакцию мозга на картинку. Поэтому в обучение можно добавлять обычные изображения, которые никто в томографе в действительности не рассматривал: кодировщик создаёт предполагаемый мозговой ответ, а декодер пытается восстановить исходную сцену.
Один из главных результатов — сокращение индивидуальной настройки. Ранее конкурентным системам требовались десятки часов фМРТ одного человека. Brain-IT, по данным авторов, после примерно часа индивидуальных записей достигает качества, сопоставимого с методами, обучавшимися на сорока часах. В материалах ICLR исследователи показывали осмысленные реконструкции даже при значительно меньшем объёме данных.
Но слово «реконструкция» здесь принципиально. Получившаяся картинка не является фотографией того, что видел человек. Модель может правильно уловить общий смысл сцены, но изменить цвет, положение детали или даже перепутать похожие объекты. Поэтому утверждение, что ИИ уже способен буквально видеть глазами человека, идёт дальше результатов эксперимента.
Профессор нейронаук Калифорнийского университета в Беркли Джек Галлант, много лет занимающийся декодированием мозга, обращает внимание и на физические ограничения самой фМРТ. Она измеряет не импульсы нейронов напрямую, а связанный с их активностью кровоток, причём с невысоким временным разрешением. Томограф остаётся многотонной стационарной установкой, а движения головы резко ухудшают данные.
Поэтому тайное дистанционное «чтение мыслей» сегодня невозможно. Галлант подчёркивает, что современные технологии требуют сотрудничества самого человека и считает недопустимым использование декодирования мозга без полного информированного согласия.
Для науки Brain-IT интересен не только эффектными восстановленными картинками. Подобные модели помогают выяснять, где и каким образом мозг кодирует цвет, форму, смысл и устройство визуальной сцены. Команда Ирани уже работает с другими типами информации и рассматривает в перспективе звук и видео.
Сновидения тоже упоминаются авторами — но именно как далёкая цель. У видео есть фундаментальная проблема: изображение меняется десятки раз в секунду, тогда как один сигнал фМРТ формируется примерно за две секунды. Между сегодняшним экспериментом и воспроизведением сна остаётся большая технологическая дистанция.
СОВЕТ ОТ РЕДАКЦИИ
Brain-IT действительно приближает нейротехнологии к тому, что ещё недавно выглядело фантастикой. Но «чтением мыслей» его пока корректнее называть условно: система реконструирует увиденную в эксперименте сцену, а не извлекает произвольные мысли, воспоминания или намерения человека.
Фото: редакция ИЗНАНКИ.